Mishandling of Exceptional Conditions چیست؟ خطر مدیریت نادرست خطاها در امنیت سایت
Mishandling of Exceptional Conditions به مدیریت نادرست Errorها و وضعیتهای غیرعادی در برنامههای وب گفته میشود و در OWASP Top 10 2025 با شناسه A10 معرفی شده است. این ضعف میتواند باعث Fail Open شدن کنترلهای امنیتی، افشای اطلاعات در پیام خطا، Resource Exhaustion، خراب شدن Transaction و ایجاد Stateهای غیرقابل پیشبینی شود. استفاده از Fail Secure، مدیریت متمرکز Exception، Rollback، Input Validation، Rate Limiting، Logging امن و Monitoring از مهمترین روشهای کاهش این ریسک هستند.
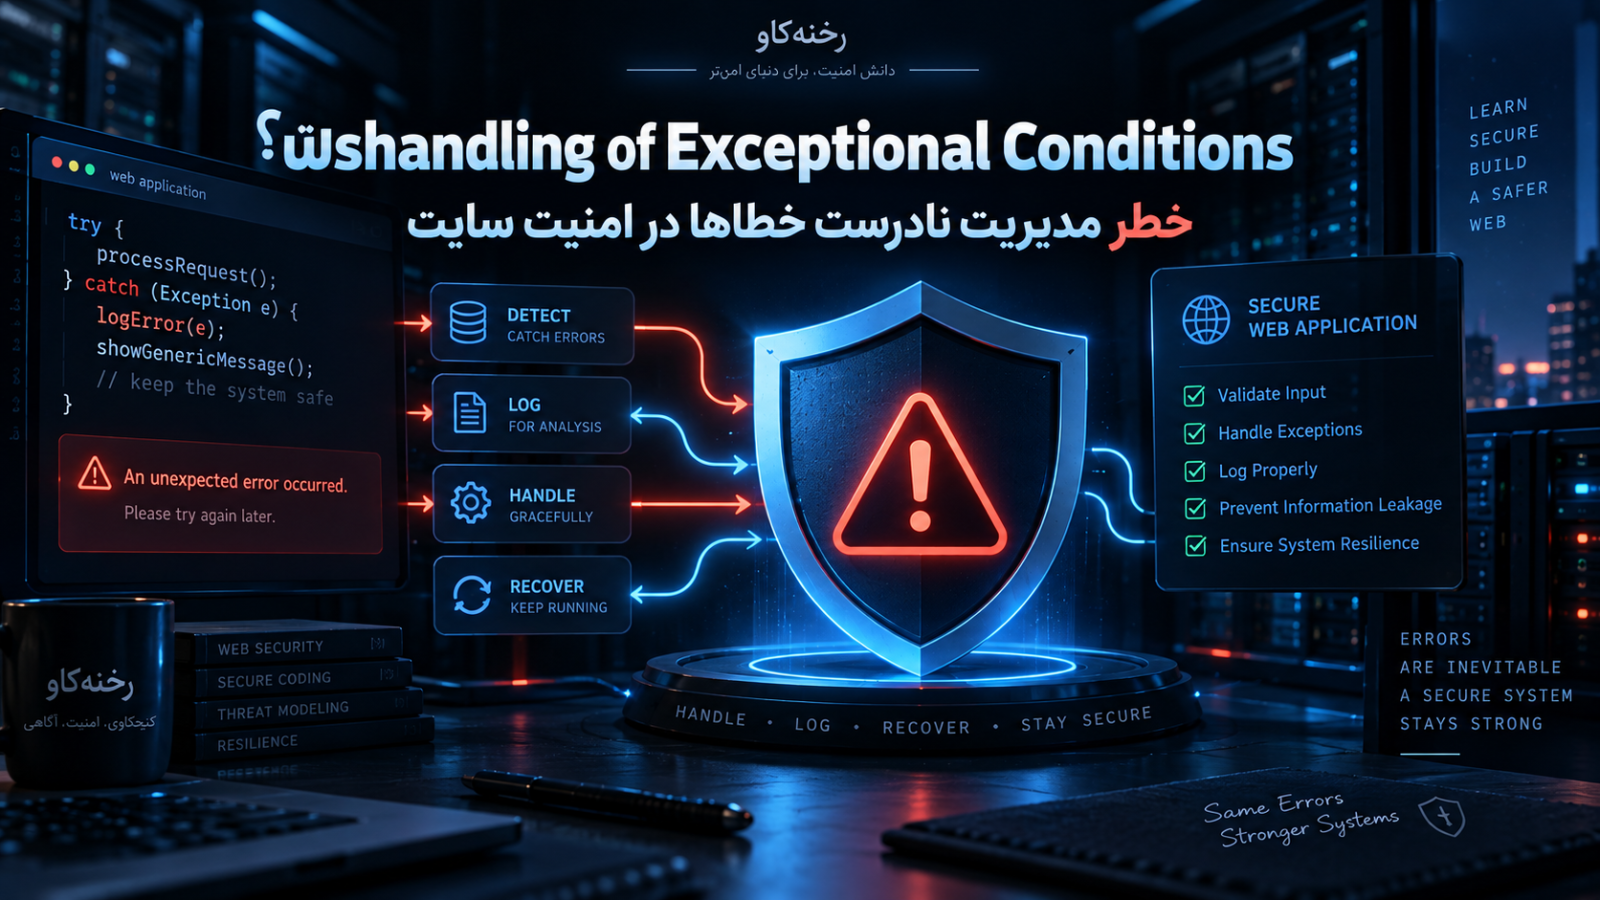
Mishandling of Exceptional Conditions یا «مدیریت نادرست شرایط استثنایی» زمانی رخ میدهد که یک سایت یا برنامه وب هنگام مواجهه با خطا، وضعیت غیرمنتظره، ورودی ناقص، قطع ارتباط، کمبود منابع یا شکست یک سرویس نتواند بهشکل امن و قابل پیشبینی واکنش نشان دهد. نتیجه میتواند از نمایش اطلاعات حساس در Error Message تا Fail Open شدن کنترلهای امنیتی، خراب شدن وضعیت تراکنش، مصرف منابع، اختلال سرویس و حتی دور زدن Authentication یا Authorization متغیر باشد.
این ریسک در OWASP Top 10 2025 با شناسه A10 معرفی شده و یک دسته جدید در نسخه ۲۰۲۵ محسوب میشود. OWASP در این دسته ۲۴ CWE را گردآوری کرده که موضوعاتی مانند مدیریت نامناسب Error، Uncaught Exception، Missing Parameter، Unchecked Return Value، نشت اطلاعات از پیام خطا، Cleanup ناقص منابع و Failing Open را پوشش میدهند.
مدیریت خطا در امنیت وب فقط به این معنا نیست که برنامه Crash نکند یا یک صفحه «خطایی رخ داده است» نمایش دهد. سؤال اصلی این است که پس از بروز خطا چه اتفاقی برای State سیستم، دسترسی کاربر، تراکنش، منابع، Logها و اطلاعات حساس میافتد.
یک سایت امن باید برای شرایط غیرعادی نیز طراحی شده باشد.
اگر Database پاسخ نداد چه میشود؟
اگر سرویس Authorization قطع شد چه؟
اگر API خارجی Timeout داد چه؟
اگر Parameter مهمی ارسال نشد چه؟
اگر عملیات مالی در مرحله دوم از سه مرحله Fail شد چه؟
اگر File Upload خطا داد، فایل موقت و Resourceها آزاد میشوند؟
اگر Exception ایجاد شد، آیا اطلاعات Database و Path سرور در Browser کاربر نمایش داده میشود؟
اگر سیستم نتواند تشخیص دهد User مجوز دارد یا خیر، درخواست را Block میکند یا Allow؟
پاسخ این سؤالها تعیین میکند Error Handling صرفاً یک قابلیت فنی است یا واقعاً بخشی از معماری امنیت برنامه محسوب میشود.
Mishandling of Exceptional Conditions دقیقاً چیست؟
Exceptional Condition به وضعیتی گفته میشود که خارج از جریان عادی یا Expected Flow یک برنامه رخ میدهد و سیستم باید برای ادامه کار درباره آن تصمیم بگیرد.
این وضعیت الزاماً یک حمله نیست.
ممکن است علت آن کاملاً عادی باشد:
اتصال Database قطع شده است.
پارامتر لازم وجود ندارد.
فایل بیش از حد بزرگ است.
حافظه کافی نیست.
API شخص ثالث پاسخ نمیدهد.
کاربر Session منقضیشده دارد.
یک عملیات همزمان باعث Conflict شده است.
Disk پر شده است.
یک Record حذف شده و برنامه انتظار وجود آن را داشته است.
اما همین شرایط اگر بهدرستی مدیریت نشوند، میتوانند به Security Vulnerability تبدیل شوند.
OWASP توضیح میدهد Mishandling of Exceptional Conditions زمانی رخ میدهد که Application در یکی یا چند مرحله شکست بخورد:
شرایط غیرمعمول را پیشگیری نکند،
هنگام وقوع آن را تشخیص ندهد،
یا پس از وقوع واکنش مناسبی نشان ندهد.
در نتیجه Application ممکن است وارد وضعیتی شود که Developer دیگر نمیتواند رفتار بعدی آن را با اطمینان پیشبینی کند.
این بخش آخر اهمیت زیادی دارد.
یک برنامه امن نباید در وضعیت «نمیدانیم بعدش چه میشود» قرار بگیرد.
جایگاه A10 در OWASP Top 10 2025
در OWASP Top 10:2025، Mishandling of Exceptional Conditions در جایگاه دهم قرار گرفته است.
فهرست کامل نسخه ۲۰۲۵ به این صورت است:
| رتبه | دسته امنیتی |
|---|---|
| A01 | Broken Access Control |
| A02 | Security Misconfiguration |
| A03 | Software Supply Chain Failures |
| A04 | Cryptographic Failures |
| A05 | Injection |
| A06 | Insecure Design |
| A07 | Authentication Failures |
| A08 | Software or Data Integrity Failures |
| A09 | Security Logging & Alerting Failures |
| A10 | Mishandling of Exceptional Conditions |
OWASP میگوید A10 یک دسته جدید در نسخه ۲۰۲۵ است و برای جدا کردن گروهی از مشکلات مشخص Error Handling و Exceptional Condition از مفهوم بسیار کلی «Poor Code Quality» ایجاد شده است.
طبق دادههای OWASP، این دسته ۲۴ CWE را شامل میشود و در Dataset استفادهشده برای Top 10، مجموعاً ۷۶۹٬۵۸۱ رخداد و ۳۴۱۶ CVE مرتبط با CWEهای آن ثبت شدهاند. این آمار به معنی آن نیست که تمام این رخدادها یک آسیبپذیری یکسان هستند؛ بلکه نشان میدهد خانواده مشکلات مرتبط با مدیریت خطا و شرایط غیرعادی دامنه گستردهای دارد.
مهمترین CWEهای مرتبط با مدیریت نادرست خطاها
OWASP چند CWE را بهعنوان نمونههای شاخص A10 معرفی میکند.
CWE-209: نمایش اطلاعات حساس در پیام خطا
CWE-209 زمانی رخ میدهد که Error Message حاوی اطلاعاتی درباره Environment، User، Query، فایلها یا ساختار داخلی Application باشد که نباید برای مخاطب نمایش داده شود.
برای مثال ممکن است Error Page موارد زیر را نشان دهد:
مسیر کامل فایل روی Server
Database Error
نام Table
بخشی از SQL Query
Framework Version
Stack Trace
نام Classها
Internal Hostname
Credential یا Token
اطلاعات Debug
MITRE توضیح میدهد چنین اطلاعاتی میتواند مستقیماً حساس باشد یا به مهاجم برای طراحی حمله دقیقتر کمک کند.
CWE-234: عدم مدیریت Parameter گمشده
Application ممکن است انتظار داشته باشد یک Parameter همیشه وجود داشته باشد.
اما مهاجم، Client معیوب یا حتی یک Bug در Frontend میتواند Requestی بدون آن Parameter ایجاد کند.
اگر برنامه برای این وضعیت Design نشده باشد، ممکن است:
Crash کند،
مقدار پیشفرض خطرناک انتخاب کند،
Authorization را Skip کند،
یا وارد یک State غیرمنتظره شود.
CWE-248: Uncaught Exception
Uncaught Exception یعنی Exception ایجاد شده اما هیچ بخش مناسبی از Application آن را مدیریت نکرده است.
نتیجه ممکن است:
قطع Request،
Crash Process،
نمایش Stack Trace،
از بین رفتن Transaction State،
یا باقی ماندن Resourceهای باز باشد.
CWE-252: Unchecked Return Value
گاهی Function یک Return Value ارائه میدهد تا موفق یا ناموفق بودن عملیات را مشخص کند.
اگر Developer آن را نادیده بگیرد، Application ممکن است فرض کند عملیات موفق بوده است.
مثلاً:
نوشتن فایل Fail شده اما برنامه عملیات را Successful ثبت میکند.
Database Update شکست خورده اما Payment Complete تلقی میشود.
Token Verification شکست خورده اما جریان بعدی ادامه پیدا میکند.
CWE-390: تشخیص خطا بدون اقدام
گاهی برنامه Error را تشخیص میدهد ولی هیچ کار مؤثری انجام نمیدهد.
وجود یک catch خالی از نظر امنیتی الزاماً بهتر از نداشتن catch نیست.
اگر Error فقط بلعیده شود، Application ممکن است در همان State نامعتبر ادامه دهد.
CWE-460: Cleanup نامناسب هنگام Exception
اگر Exception باعث شود File Handle، Lock، Connection یا Memory Resource آزاد نشود، تکرار خطا میتواند Resource Exhaustion ایجاد کند.
CWE-636: Failing Open
یکی از مهمترین مفاهیم این دسته Fail Open است.
MITRE این ضعف را زمانی تعریف میکند که محصول هنگام Failure به یک State با امنیت کمتر برود؛ مثلاً Access Control ضعیفتر یا تنظیمات مجازتر انتخاب کند.
تفاوت Error، Exception و Exceptional Condition
این سه اصطلاح گاهی بهجای یکدیگر استفاده میشوند، اما بهتر است تفاوت مفهومی آنها را بدانیم.
Error
Error یک اصطلاح عمومی برای وضعیت ناموفق است.
برای مثال:
Database Connection Error
File Read Error
Invalid Input Error
HTTP Error
Exception
Exception معمولاً مکانیزمی در زبان برنامهنویسی است که یک وضعیت غیرعادی را از محل وقوع به بخش دیگری از Code منتقل میکند.
برای مثال Function میتواند Exception پرتاب کند و Caller آن را Catch کند.
Exceptional Condition
Exceptional Condition مفهوم گستردهتری است.
ممکن است هیچ Exception برنامهنویسی تولید نشود اما سیستم وارد وضعیت غیرعادی شود.
مثلاً:
یک عملیات دو بار انجام شود.
Resource Limit تمام شود.
API پاسخ غیرمنتظره بدهد.
State یک Transaction ناقص بماند.
دو Request همزمان Race Condition ایجاد کنند.
بنابراین امنیت این دسته فقط با try/catch حل نمیشود.
چرا Error Handling یک موضوع امنیتی است؟
بعضی Developers مدیریت Error را فقط موضوع User Experience یا Stability میدانند.
اما Error Handling میتواند مستقیماً روی سه اصل اصلی امنیت اطلاعات اثر بگذارد:
Confidentiality
Integrity
Availability
اثر بر Confidentiality
اگر Stack Trace، Query، Secret یا Internal Path در Error نمایش داده شود، محرمانگی اطلاعات کاهش پیدا میکند.
اثر بر Integrity
اگر یک Transaction هنگام Failure بهطور کامل Rollback نشود، ممکن است Data وارد وضعیت ناسازگار شود.
اثر بر Availability
اگر Exception باعث Resource Leak، Infinite Retry یا Crash شود، سرویس ممکن است از دسترس خارج شود.
OWASP نیز تأکید میکند Mishandling of Exceptional Conditions میتواند روی محرمانگی، یکپارچگی و دسترسپذیری سیستم و اطلاعات اثر بگذارد.
Fail Open چیست؟
Fail Open یکی از خطرناکترین رفتارهای ممکن هنگام Error است.
فرض کنید یک Endpoint حساس قبل از اجرای عملیات از Authorization Service سؤال میکند:
«آیا این User اجازه انجام عملیات را دارد؟»
سه پاسخ طبیعی داریم:
Allow
Deny
Service unavailable
طراحی خطرناک این است:
اگر Authorization Service پاسخ نداد، عملیات را Allow کن تا User Experience خراب نشود.
در این شرایط Failure کنترل امنیتی باعث باز شدن دسترسی میشود.
این رفتار Fail Open است.
مثال ساده دیگر
فرض کنید سیستم برای بررسی Account Status به Database نیاز دارد.
اگر Database Error ایجاد کرد و Code چنین منطقی داشته باشد:
«اگر نتوانستیم Blocked بودن Account را تأیید کنیم، Login را ادامه بده.»
این تصمیم امنیتی خطرناک است.
عدم دسترسی به اطلاعات نباید بهطور پیشفرض معادل تأیید امنیت تلقی شود. 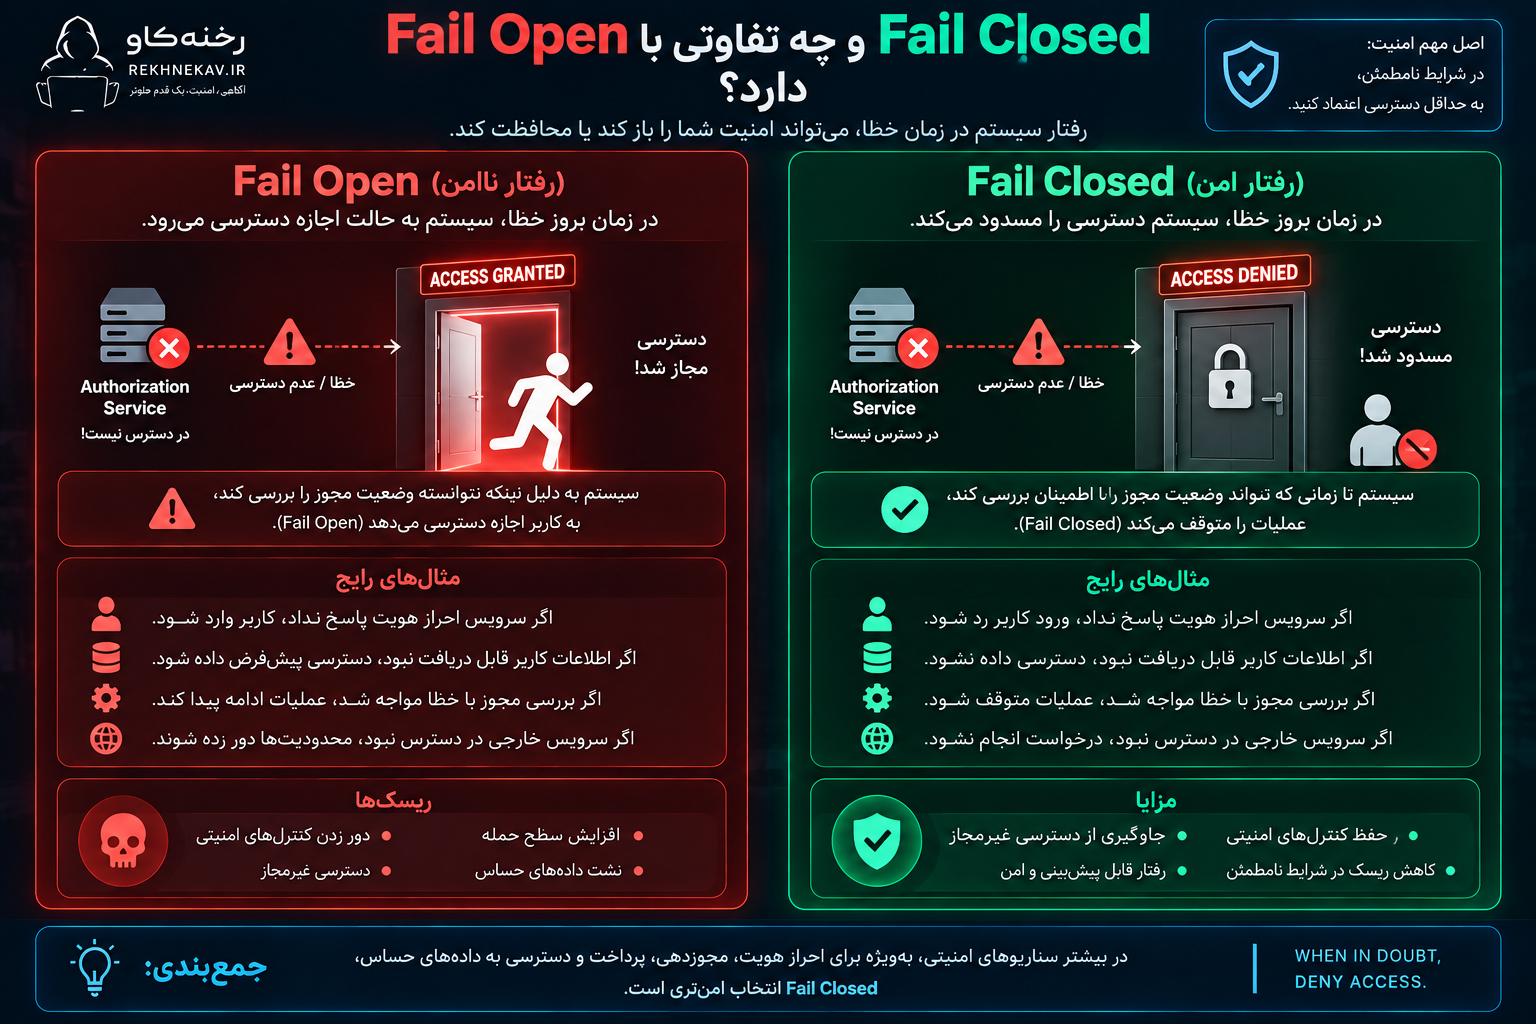
Fail Closed یا Fail Secure چیست؟
Fail Closed یعنی هنگام Failure حساس، سیستم عملیات را متوقف کند تا وضعیت امنیتی مشخص شود.
مثلاً:
Authorization قابل تأیید نیست → عملیات حساس انجام نشود.
Payment Status مشخص نیست → سفارش Paid اعلام نشود.
Signature Verification Fail شده → Data معتبر تلقی نشود.
Session Validation قابل انجام نیست → دسترسی حساس صادر نشود.
این اصل با اصطلاح Fail Secure نیز بیان میشود.
با این حال Fail Closed نباید بدون Architecture مناسب استفاده شود.
اگر همه Errorها باعث Block دائمی Application شوند، مهاجم ممکن است همان Failure Path را به Denial of Service تبدیل کند.
بنابراین Design باید بین Security و Availability تعادل آگاهانه ایجاد کند.
Fail Open و Fail Closed چه تفاوتی دارند؟
| وضعیت | Fail Open | Fail Closed |
|---|---|---|
| شکست Authorization Service | اجازه دسترسی | مسدود کردن عملیات |
| عدم تأیید Permission | Allow | Deny |
| Signature Validation Error | قبول Data | رد Data |
| وضعیت نامشخص Transaction | ادامه عملیات | توقف یا Rollback |
| ریسک امنیتی | معمولاً بالاتر | معمولاً کمتر |
| ریسک Availability | کمتر | ممکن است بیشتر باشد |
قاعده عمومی این است که عملیات امنیتی حساس نباید به دلیل Failure به حالت permissive منتقل شوند.
نمایش Stack Trace چرا خطرناک است؟
Stack Trace برای Developer بسیار مفید است.
میتواند نشان دهد:
Exception کجا رخ داده،
کدام Function فراخوانی شده،
چه Classهایی استفاده میشوند،
File Path چیست،
چه Frameworkی وجود دارد.
اما همین اطلاعات برای فرد مهاجم نیز مفید هستند.
OWASP Error Handling Cheat Sheet توضیح میدهد Errorهای مدیریتنشده میتوانند اطلاعات Technical Stack را در مرحله Reconnaissance آشکار کنند.
یک Error Page نامناسب ممکن است چه چیزهایی فاش کند؟
مثلاً:
/var/www/example/app/controllers/UserController.php
یا:
نام Database Driver
نسخه Framework
SQL Query
Internal IP
Library Path
Configuration Key
این اطلاعات ممکن است بهتنهایی Vulnerability نباشند، اما Attack Surface را برای مهاجم روشنتر میکنند. 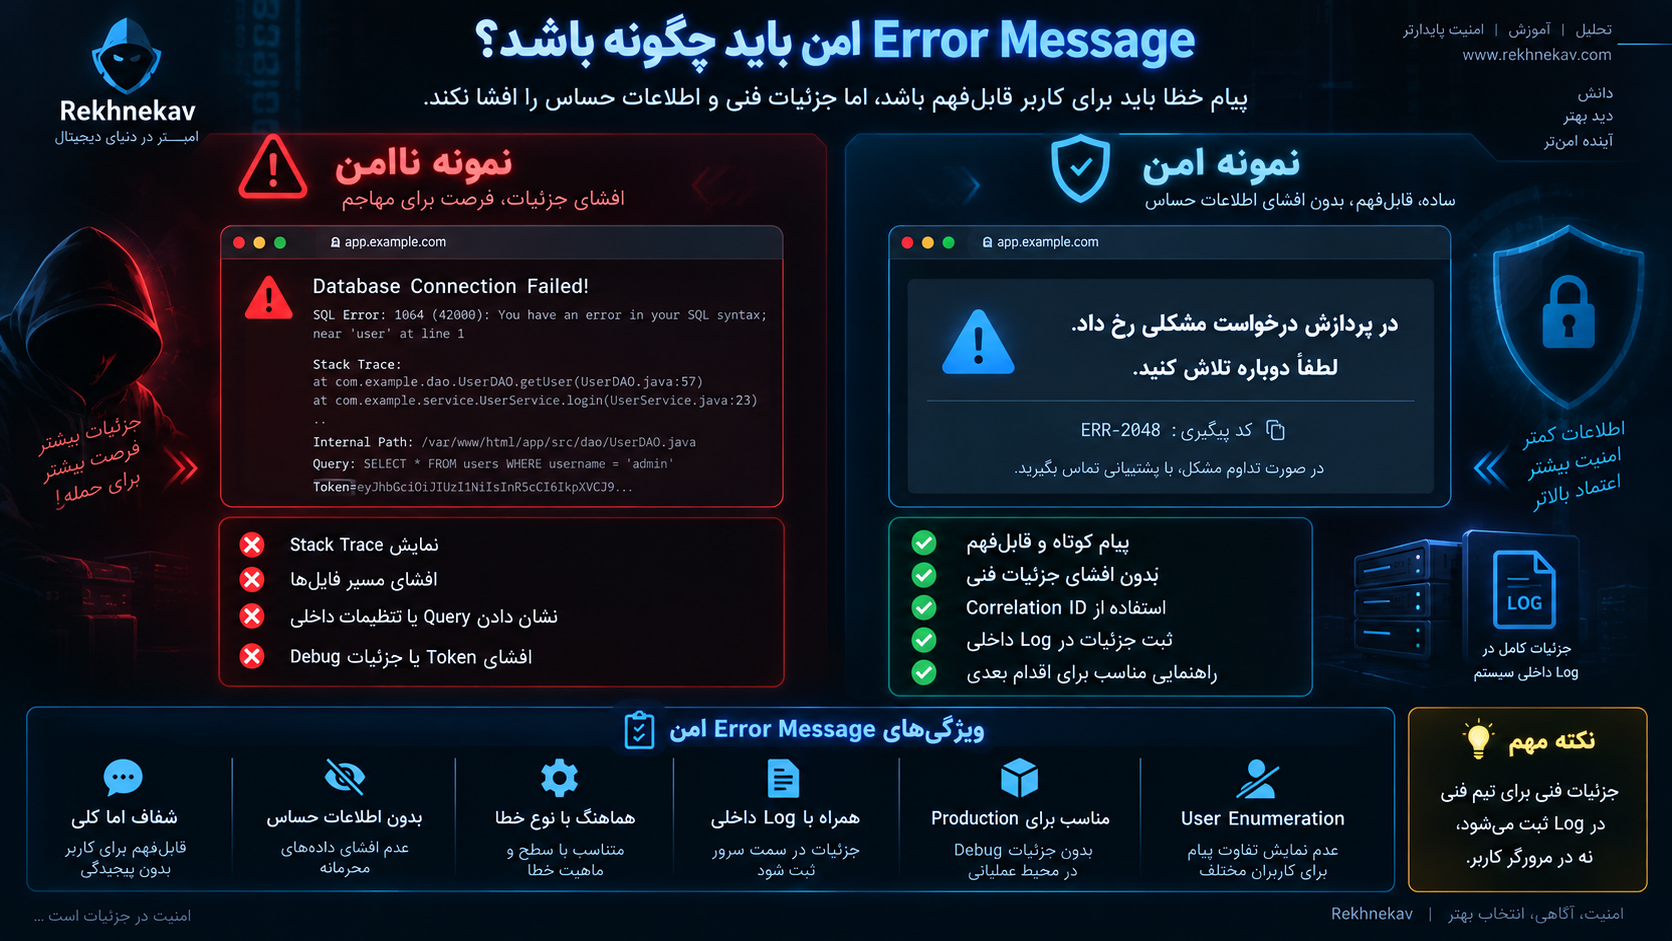
Error Message امن باید چگونه باشد؟
Error Message برای User باید به اندازه کافی مفید باشد که متوجه شود عملیات موفق نبوده، اما نباید Implementation Detail را فاش کند.
برای مثال بهجای نمایش:
DatabaseException: connection to mysql-prod-02 failed on 10.0.0.18...
میتوان به User گفت:
«در پردازش درخواست مشکلی رخ داده است. لطفاً دوباره تلاش کنید.»
و در Log داخلی اطلاعات فنی لازم ثبت شود.
اصل مهم
پیامی که User میبیند با اطلاعاتی که Developer برای Troubleshooting نیاز دارد یکسان نیست.
این دو Audience نیازهای متفاوتی دارند.
MITRE برای CWE-209 نیز توصیه میکند Error Message تنها حداقل اطلاعات موردنیاز مخاطب را نمایش دهد و جزئیات فنی در Log داخلی مدیریت شوند.
آیا باید تمام جزئیات Error را Log کنیم؟
نه لزوماً.
عبارت «جزئیات Error را به User ندهید، در Log بنویسید» اگر بدون محدودیت اجرا شود خودش میتواند مشکل امنیتی ایجاد کند.
Log نباید شامل اطلاعاتی مانند:
Password
Full Session Token
Private Key
API Secret
Authorization Header
Credit Card Data
Recovery Token
اطلاعات محرمانه غیرضروری
باشد.
Log نیز Data است و باید محافظت شود.
اگر مهاجم بتواند Log File را بخواند، Secretهایی که داخل آن نوشته شدهاند در معرض خطر قرار میگیرند.
Correlation ID چیست؟
یکی از روشهای خوب Error Handling استفاده از Correlation ID یا Error Reference است.
به User بهجای Stack Trace گفته میشود:
«خطایی رخ داده است. کد پیگیری: ABC-12345»
همان ID در Log نیز ثبت میشود.
Support Team میتواند با این ID خطای دقیق را پیدا کند بدون اینکه Internal Detail در Browser User منتشر شود.
این الگو برای سیستمهای بزرگ، Microservice و API بسیار کاربردی است. 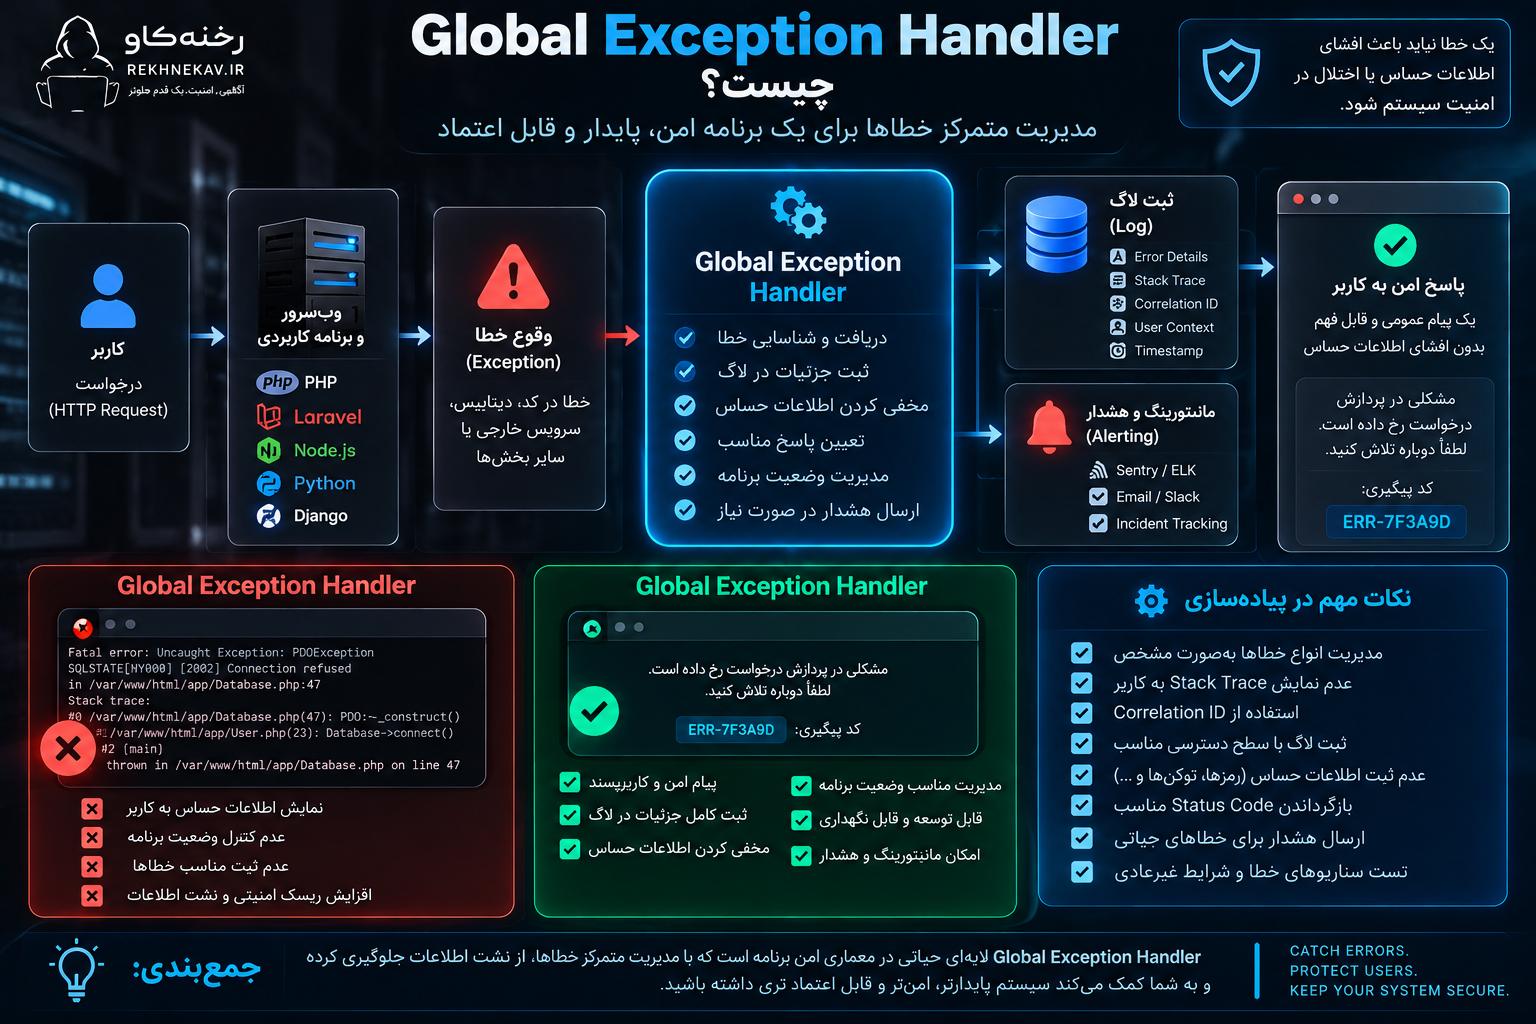
Global Exception Handler چیست؟
Global Exception Handler آخرین لایه دفاعی در برابر Exceptionهایی است که هیچ بخش محلی Code آنها را مدیریت نکرده است.
هدف آن این نیست که تمام Error Handling Application را به یک catch all بزرگ منتقل کنیم.
بلکه نقش Safety Net را دارد.
Global Handler معمولاً باید بتواند:
Exception را ثبت کند،
Correlation ID ایجاد کند،
Response استاندارد برگرداند،
اطلاعات حساس را مخفی کند،
Status Code مناسب ایجاد کند،
در صورت نیاز Alert ایجاد کند.
OWASP توصیه میکند علاوه بر مدیریت Error در محل مناسب، یک Global Exception Handler برای مواردی که از دست رفتهاند وجود داشته باشد.
چرا فقط Global Exception Handler کافی نیست؟
فرض کنید Transfer مالی شامل سه مرحله باشد:
- کم کردن مبلغ از حساب A
- اضافه کردن مبلغ به حساب B
- ثبت Transaction
اگر مرحله دوم Exception ایجاد کند و فقط Global Handler Error را ثبت کند، سؤال مهم باقی میماند:
مرحله اول چه میشود؟
Global Handler Context لازم برای Restore کردن Business State را الزاماً ندارد.
به همین دلیل Error باید در نزدیکترین سطحی مدیریت شود که بتواند درباره State تصمیم درست بگیرد.
Global Handler آخرین Safety Net است، نه جایگزین Error Handling منطقی.
Generic Catch چرا همیشه روش خوبی نیست؟
یکی از Anti-patternها این است که هر Function چنین ساختاری داشته باشد:
catch (Exception)
و همه انواع خطا را یکسان مدیریت کند.
مشکل این است که Errorهای مختلف معنی متفاوت دارند.
مثلاً:
Invalid Input
Permission Denied
Database Timeout
Resource Not Found
Payment Rejected
Internal Programming Error
نباید همگی یک رفتار یکسان ایجاد کنند.
OWASP در A10 حتی CWE-396، یعنی Declaration of Catch for Generic Exception را در میان CWEهای مرتبط قرار داده است.
هدف این نیست که Generic Handler هیچوقت استفاده نشود؛ بلکه Errorهای قابل پیشبینی باید در سطح مناسب و با Response متناسب مدیریت شوند.
Empty Catch Block چه مشکلی دارد؟
یکی از بدترین الگوها این است:
خطا Catch شود،
ولی هیچ عملی انجام نشود.
این کار باعث میشود Developer تصور کند Error مدیریت شده، در حالی که Application فقط Error را پنهان کرده است.
ممکن است:
Data ناقص باقی بماند،
Lock آزاد نشود،
State نامعتبر شود،
User نتیجه اشتباه بگیرد،
Monitoring هیچ چیزی نبیند.
Error Handling باید Meaningful باشد.
گاهی Meaningful Handling به معنی Retry است.
گاهی Rollback.
گاهی Return Error.
گاهی Alert.
گاهی Cleanup.
اما «هیچ کاری نکردن» معمولاً Handling محسوب نمیشود. 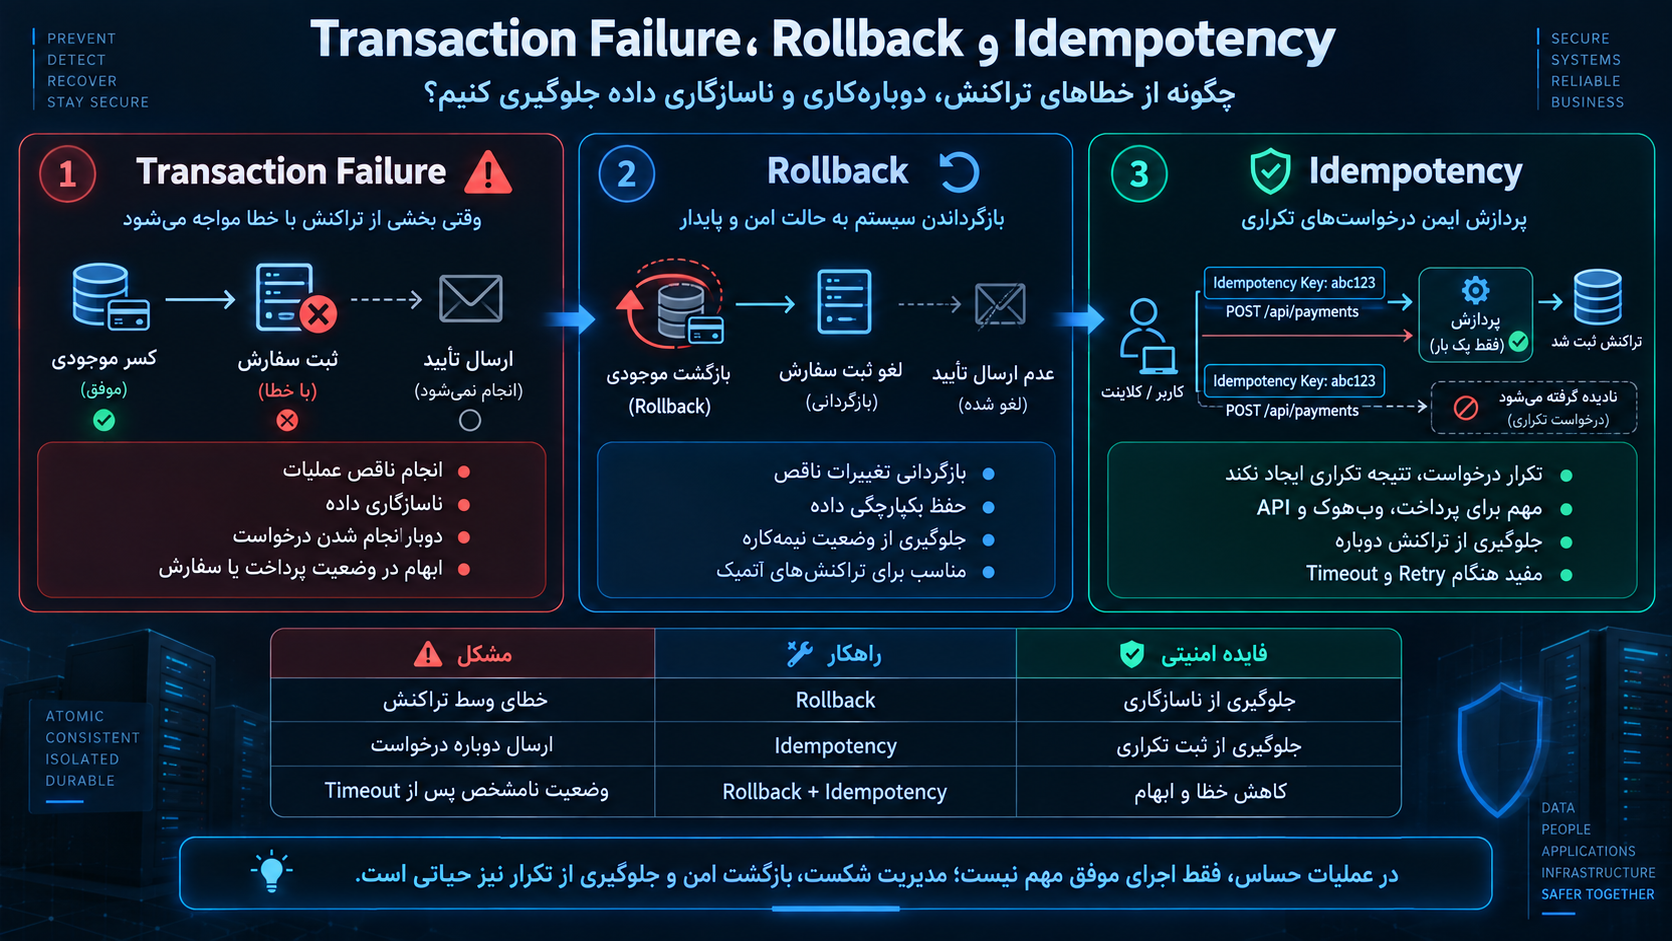
Transaction Failure چرا در امنیت مهم است؟
Transactionهای چندمرحلهای یکی از مهمترین نقاط Exceptional Conditions هستند.
مثلاً انتقال پول:
Debit A
Credit B
Record Transaction
اگر فقط دو مرحله اول انجام شوند چه؟
اگر فقط Debit انجام شود چه؟
اگر User دوباره Request را ارسال کند چه؟
اگر Callback دوبار دریافت شود چه؟
اگر Network بعد از موفقیت Server ولی قبل از دریافت Response قطع شود چه؟
OWASP در Scenario رسمی A10 یک مثال مشابه ارائه میکند و تأکید میکند در Failure باید Transaction به شکل کامل Rollback شود تا سیستم وارد State ناسازگار نشود.
Rollback چیست؟
Rollback یعنی تغییرات ناقص یک Transaction لغو شوند تا سیستم به State معتبر قبلی بازگردد.
فرض کنید عملیات شامل:
کاهش موجودی کالا
ثبت سفارش
کسر Wallet
است.
اگر کسر Wallet Fail شود ولی موجودی قبلاً کم شده باشد، باید تصمیم مشخصی برای Rollback وجود داشته باشد.
هدف این است که Partial Success به Data Corruption تبدیل نشود.
Atomicity چیست؟
Atomicity یعنی مجموعهای از عملیات مهم یا باید کاملاً انجام شوند یا اصلاً انجام نشوند.
در Database Transactionها مفهوم Atomicity یکی از اصول اصلی ACID است.
اما Business Transaction ممکن است چندین سرویس را شامل شود و Atomicity سنتی Database کافی نباشد.
در Microserviceها ممکن است نیاز به Patternهایی مانند Compensating Transaction یا Saga وجود داشته باشد.
نکته امنیتی این است:
Failure State باید از قبل طراحی شده باشد.
Idempotency چه ارتباطی با مدیریت خطا دارد؟
فرض کنید User دکمه Payment را میزند.
Server عملیات را انجام میدهد، اما Network قبل از رسیدن Response قطع میشود.
Client نمیداند Payment موفق بوده یا نه.
اگر Request دوباره ارسال شود چه؟
اگر Endpoint Idempotent نباشد، ممکن است پرداخت دو بار انجام شود.
Idempotency یعنی اجرای تکراری یک Request مشخص، نتیجه ناخواسته چندباره ایجاد نکند.
این موضوع خصوصاً در موارد زیر مهم است:
Payment
Order
Wallet
Subscription
Webhook
Refund
Provisioning
Failure و Retry بدون Idempotency میتوانند Business State را خراب کنند. 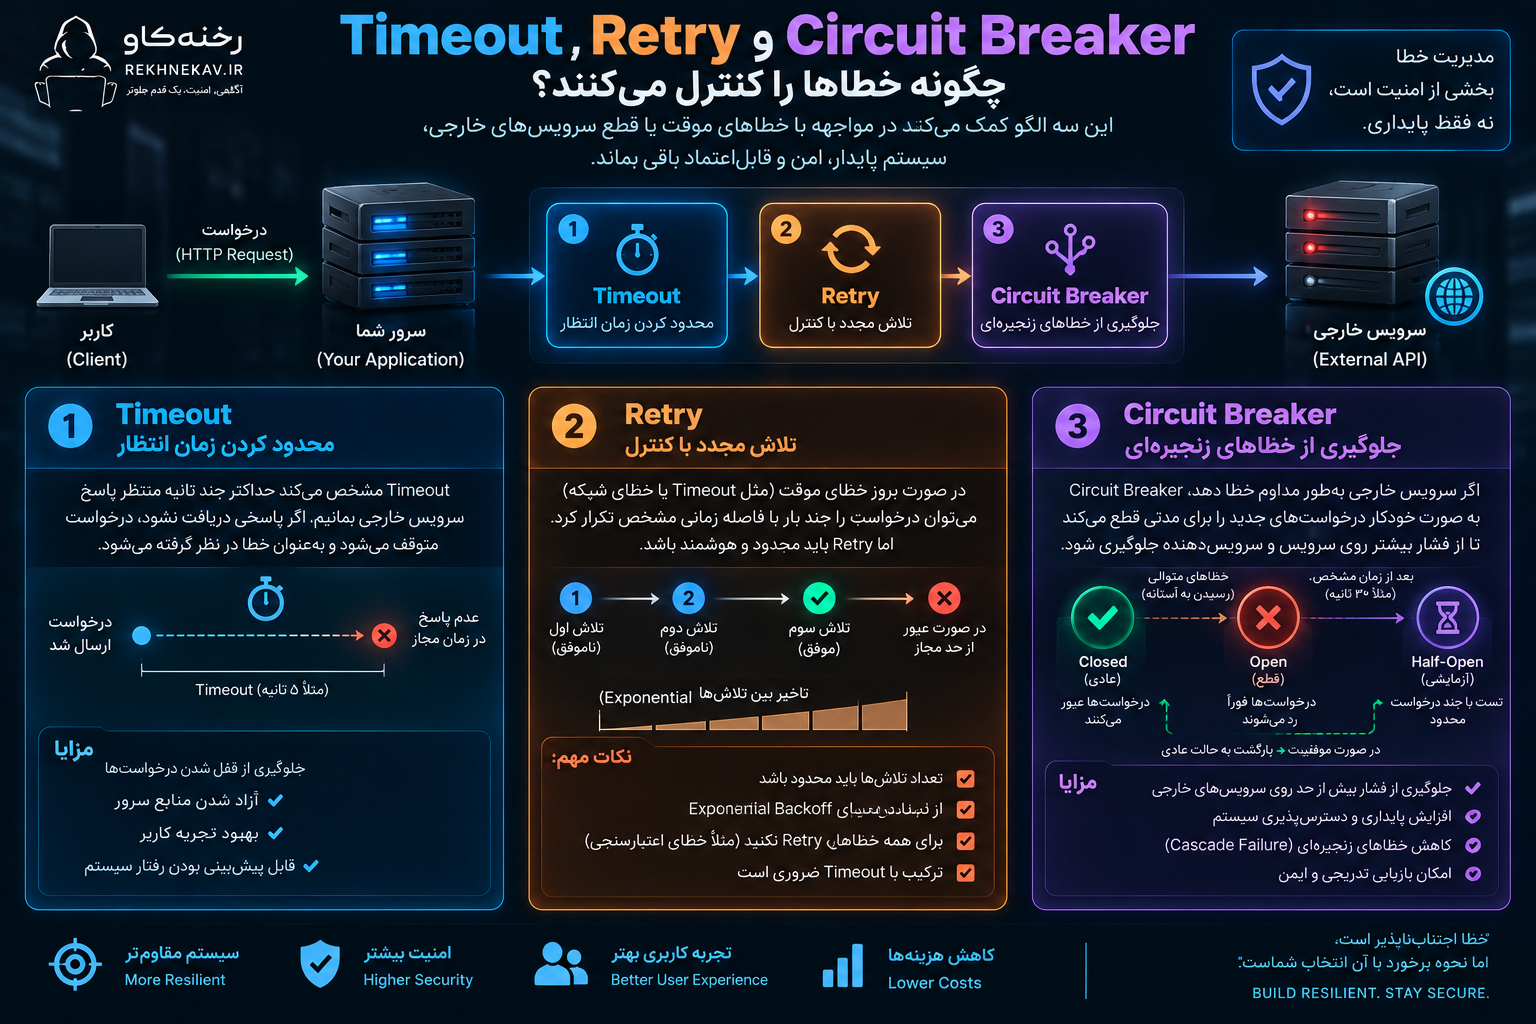
Timeout چیست؟
Network همیشه قابل اعتماد نیست.
هر Request خارجی باید احتمال Timeout داشته باشد.
اگر Application منتظر API دیگری باشد و Timeout تعریف نشده باشد، Connection ممکن است مدت زیادی Resource را اشغال کند.
در حجم بالا این موضوع میتواند Availability را کاهش دهد.
Timeout مناسب باید برای:
HTTP Request
Database Query
Queue
File Operation
Remote API
تعریف شود.
اما Timeout بهتنهایی کافی نیست.
بعد از Timeout باید معلوم باشد State عملیات چیست.
Retry چگونه میتواند خطرناک شود؟
Retry یک تکنیک معمول Resilience است.
اما Retry بدون Design مناسب ممکن است شرایط را بدتر کند.
مثلاً External Service زیر فشار است.
Application به ازای هر Failure بلافاصله پنج Retry انجام میدهد.
Traffic پنج برابر میشود و Service بیشتر تحت فشار قرار میگیرد.
این وضعیت میتواند Retry Storm ایجاد کند.
Retry امنتر معمولاً نیازمند مواردی مانند:
حداکثر تعداد Retry
Delay
Exponential Backoff
Jitter
Idempotency
Timeout
Circuit Breaker
است.
هدف این است که Recovery خودش به Failure بزرگتر تبدیل نشود.
Circuit Breaker چیست؟
Circuit Breaker الگویی است که وقتی Dependency مرتب Fail میشود، Application برای مدتی Requestهای جدید به آن Dependency را متوقف میکند.
مشابه فیوز برق عمل میکند.
هدف:
جلوگیری از فشار بیشتر،
کاهش Resource Consumption،
امکان Recovery برای سرویس مقصد.
اما Fallback Circuit Breaker نیز باید امن باشد.
مثلاً اگر Identity Provider Down است، Fallback نباید «ورود همه کاربران بدون Authentication» باشد.
Resource Exhaustion چیست؟
Exception Handling ضعیف میتواند باعث باقی ماندن Resourceهای مصرفشده شود.
مثلاً:
File Handle
Database Connection
Memory
Thread
Socket
Lock
Temporary File
اگر هر Error یک Resource را آزاد نکند، مهاجم میتواند Error را بارها Trigger کند و منابع سیستم را تمام کند.
OWASP Scenario شماره یک A10 دقیقاً نمونهای از Resource Exhaustion را توضیح میدهد: Exception هنگام File Upload رخ میدهد، Resource بهدرستی آزاد نمیشود و تکرار آن میتواند Availability را مختل کند.
Cleanup باید چگونه طراحی شود؟
Resourceهایی که Acquire میشوند باید مسیر Release مشخص داشته باشند.
حتی اگر Exception رخ دهد.
در بسیاری از زبانها مکانیزمهایی مانند:
finally
defer
RAII
context manager
برای کمک به Cleanup وجود دارند.
Developer باید بررسی کند:
File بسته میشود؟
Connection به Pool برمیگردد؟
Lock آزاد میشود؟
Transaction پایان پیدا میکند؟
Temporary Data حذف میشود؟
Cleanup بخشی از Security است، نه فقط Performance.
Rate Limiting چگونه از Exceptional Conditions جلوگیری میکند؟
بهترین Error Handler خطایی را مدیریت میکند که رخ داده است.
اما بهتر از آن این است که بعضی Exceptional Conditionها اصلاً ایجاد نشوند.
OWASP در A10 توصیه میکند از:
Rate Limiting
Resource Quota
Throttling
Limit
برای جلوگیری از Resource Exhaustion و شرایط شدید استفاده شود.
مثلاً:
حداکثر File Size
حداکثر تعداد Upload
حداکثر Concurrent Request
حداکثر Login Attempt
Query Limit
API Quota
میتوانند جلوی شرایط غیرعادی را قبل از Error بگیرند.
Input Validation چه نقشی دارد؟
بخش قابل توجهی از Exceptional Conditionها از ورودیهای ناقص یا غیرمنتظره شروع میشوند.
برنامه نباید فرض کند:
Parameter همیشه وجود دارد.
String همیشه کوتاه است.
Number همیشه مثبت است.
Array همیشه حداقل یک عضو دارد.
JSON همیشه Schema مورد انتظار را دارد.
File همیشه Format صحیح دارد.
Input Validation باید در سمت Server انجام شود.
Frontend Validation برای UX مفید است، اما Security Boundary نیست.
Missing Parameter چگونه مشکل امنیتی ایجاد میکند؟
مثلاً Endpoint زیر پارامتر role دریافت میکند.
Developer فرض کرده Frontend همیشه مقدار ارسال میکند.
اما اگر Parameter حذف شود، Code ممکن است مقدار Default دریافت کند.
اگر Default به اشتباه admin یا سطح دسترسی بالا باشد، Missing Parameter تبدیل به Security Issue میشود.
طراحی بهتر باید مشخص کند:
Required Parameter گم شده → Request Reject شود.
نه اینکه Application رفتار مبهم انتخاب کند.
Extra Parameter هم میتواند خطرناک باشد
فقط Parameter گمشده مهم نیست.
OWASP CWE-235 یعنی Improper Handling of Extra Parameters را نیز در A10 قرار داده است.
فرض کنید فرم Profile فقط اجازه تغییر Name را میدهد.
اما Backend تمام JSON Object را مستقیم روی User Model اعمال میکند.
اگر Request شامل:
role
is_admin
یا Field دیگری باشد چه؟
Application باید مشخص کند چه Inputهایی Accept میشوند، نه اینکه هر Data اضافی را نادیده یا اعمال کند.
Null و Undefined State
Null Pointer Dereference یا دسترسی به Object وجودنداشته میتواند Crash ایجاد کند.
در Web Application ممکن است دلیل آن:
Record حذفشده،
Missing Relation،
Race Condition،
API Response ناقص،
Session منقضیشده
باشد.
OWASP CWE-476 را از CWEهای شاخص این دسته معرفی کرده است.
هدف فقط جلوگیری از Crash نیست.
باید بررسی شود آیا Null باعث Skip شدن Security Check یا ایجاد Default خطرناک میشود.
وضعیت Permission ناکافی چگونه باید مدیریت شود؟
Permission Error نباید مشابه System Error مدیریت شود.
اگر User مجوز عملیات ندارد، Application باید:
عملیات را Reject کند،
Status مناسب برگرداند،
در صورت اهمیت Log ایجاد کند،
اما نباید Internal Detail Permission Model را افشا کند.
یکی از CWEهای A10، Improper Handling of Insufficient Privileges است.
مثلاً Application نباید بگوید:
«شما Admin نیستید، اما به علت خطا عملیات ادامه پیدا میکند.»
Permission Failure باید Failure واقعی باشد.
Authentication Failure و Exceptional Condition
فرض کنید Token Verification Service Error ایجاد کند.
سه وضعیت متفاوت داریم:
Token معتبر است.
Token نامعتبر است.
Verification Service در دسترس نیست.
وضعیت سوم نباید بهعنوان وضعیت اول تفسیر شود.
همچنین Application باید تفاوت بین:
Invalid Credential
Service Failure
Rate Limit
Account Locked
را در Logic داخلی تشخیص دهد، حتی اگر Response خارجی برای جلوگیری از Information Disclosure مشابه باشد.
Error Handling در REST API
API باید Error Contract مشخص داشته باشد.
مثلاً:
Status Code مناسب
Error Code
User-safe Message
Correlation ID
اما نباید مواردی مثل:
Stack Trace
Database Query
Secret
Internal Service Name غیرضروری
را به Client ارسال کند.
OWASP REST Security Cheat Sheet توصیه میکند APIها Generic Error Message برگردانند و Call Stack یا Internal Technical Detail را به Client منتقل نکنند.
آیا همه خطاها باید HTTP 200 برگردانند؟
خیر.
برگرداندن HTTP 200 برای تمام Responseها و قرار دادن Error داخل Body میتواند Monitoring، Client Logic و Security Controlها را پیچیده کند.
API باید از Status Codeهای متناسب استفاده کند.
مثلاً در Context مناسب:
400 برای Request نامعتبر
401 برای Authentication موردنیاز یا نامعتبر
403 برای Forbidden
404 برای Resource نبودن
409 برای Conflict
429 برای Rate Limit
500 برای Internal Error
503 برای Service Unavailable
البته انتخاب دقیق باید مطابق API Contract انجام شود.
آیا Error Messageهای Authentication باید متفاوت باشند؟
در بعضی Flowها تفاوت بیش از حد Message میتواند User Enumeration ایجاد کند.
مثلاً:
«این ایمیل وجود ندارد.»
در مقابل:
«رمز عبور حساب example@example.com اشتباه است.»
فرد مهاجم میتواند از تفاوت Response متوجه وجود Account شود.
در چنین مواردی Response خارجی باید با Threat Model سازگار باشد.
جزئیات بیشتر میتواند در Log امن ذخیره شود.
مدیریت خطا در File Upload
File Upload یکی از بخشهایی است که Exception Handling اهمیت زیادی دارد.
باید مشخص شود:
اگر Upload نصفه قطع شد چه؟
Temporary File حذف میشود؟
Disk Quota وجود دارد؟
File Size محدود است؟
Timeout وجود دارد؟
Scanner خطا داد چه؟
Storage Service قطع شد چه؟
Database Record ثبت شد ولی File ذخیره نشد چه؟
File ذخیره شد ولی Database Update Fail شد چه؟
اگر این Stateها طراحی نشده باشند، Upload میتواند:
فایل Orphan ایجاد کند،
Storage را پر کند،
Resource Leak ایجاد کند،
یا Metadata و File را ناسازگار کند.
Error Handling در Database
Database Failureها انواع مختلفی دارند:
Connection Failure
Deadlock
Timeout
Constraint Violation
Duplicate Key
Transaction Conflict
Disk Failure
Application نباید همه این موارد را یکسان تلقی کند.
مثلاً Retry روی Deadlock ممکن است منطقی باشد.
Retry روی Validation Error احتمالاً بیمعنی است.
Retry دائمی روی Database Down میتواند Failure را تشدید کند.
Race Condition و Error Handling
Race Condition زمانی رخ میدهد که نتیجه عملیات به Timing چند Process یا Request وابسته باشد.
مثلاً دو Request همزمان موجودی یک Wallet را میخوانند و هر دو تصور میکنند Balance کافی است.
اگر Concurrency Control مناسب وجود نداشته باشد، Logic میتواند نتیجه اشتباه ایجاد کند.
OWASP A10 اشاره میکند مدیریت نامناسب Exceptional Condition میتواند با Race Condition و Timing Issue مرتبط باشد.
Error Handling در Microservice
در Microservice Architecture تعداد Failure Pointها بیشتر میشود.
Service A به B وابسته است.
B به C.
C به Database.
Failure هر کدام ممکن است روی دیگران اثر بگذارد.
معماری باید برای مواردی مانند:
Timeout
Retry
Circuit Breaker
Queue
Dead Letter Queue
Fallback
Idempotency
Distributed Transaction
Observability
برنامه داشته باشد.
هیچ Microservice نباید تصور کند شبکه همیشه کار میکند.
Partial Failure چیست؟
در Distributed System ممکن است بخشی از سیستم سالم و بخش دیگری Fail باشد.
مثلاً:
Web Server سالم است.
Database سالم است.
Payment Provider Down است.
کاربر میتواند وارد سایت شود اما Payment انجام نمیشود.
Application باید Partial Failure را تشخیص دهد و UI/Workflow را متناسب تغییر دهد.
بدترین رفتار این است که Payment را موفق نشان دهد صرفاً چون بخش داخلی Application Error را Catch کرده است.
Logging چه نقشی در A10 دارد؟
Exception بدون Logging ممکن است ماهها تکرار شود و تیم فنی از وجود آن اطلاع نداشته باشد.
اما Logging بهتنهایی کافی نیست.
باید بدانیم:
چه چیز Log شود؟
با چه Severity؟
چه Contextی؟
چه زمانی Alert ایجاد شود؟
OWASP A10 توصیه میکند Error Handling شامل Logging و در صورت نیاز Alerting باشد. همچنین Monitoring و Observability برای شناسایی الگوهای تکراری Error اهمیت دارند.
Alerting چه زمانی لازم است؟
هر Error نباید Pager را فعال کند.
اگر برای هر 404 Alert ایجاد شود، تیم خیلی زود Alert Fatigue پیدا میکند.
Alert باید برای موارد معنیدار طراحی شود.
مثلاً:
افزایش شدید Authentication Failure
تکرار Database Exception
افزایش 500 Error
تکرار Signature Validation Error
افزایش File Upload Failure
Resource نزدیک Limit
Unexpected Permission Failure
تکرار Error خاص از یک IP یا Account
Monitoring باید Pattern را ببیند، نه فقط Event منفرد.
Observability چیست؟
Observability معمولاً با سه جزء اصلی شناخته میشود:
Logs
Metrics
Traces
این سه میتوانند کمک کنند بفهمیم Error:
کجا شروع شده،
چه سرویسهایی را طی کرده،
چقدر طول کشیده،
چه Resourceهایی درگیر بودهاند.
برای Distributed Application، Trace ID و Correlation ID اهمیت زیادی دارند.
تفاوت A09 و A10 چیست؟
A09: Security Logging & Alerting Failures درباره این است که آیا Security Event بهدرستی ثبت، پایش و به Action تبدیل میشود.
A10: Mishandling of Exceptional Conditions درباره رفتار Application هنگام Error و وضعیت غیرعادی است.
این دو به هم مرتبطاند.
مثلاً:
Application Exception را بد مدیریت میکند → A10
همان Exception را اصلاً Log نمیکند → A09 نیز مطرح میشود.
Exception Handling در WordPress
سایتهای WordPress نیز میتوانند در معرض مشکلات Error Handling باشند.
خصوصاً در:
Plugin اختصاصی
Theme سفارشی
REST API
Ajax Handler
Payment Integration
WooCommerce Hook
Cron
External API
File Processing
WP_DEBUG در Production
WordPress ابزارهای Debug مفیدی دارد، اما مستندات رسمی WordPress توصیه میکنند WP_DEBUG و ابزارهای Debug روی سایت Live استفاده نشوند و بیشتر برای Local Development و Staging هستند.
نمایش Errorهای PHP به کاربران سایت Production ممکن است اطلاعات فنی درباره Path، Plugin، Theme یا Code داخلی آشکار کند.
WordPress Developer Documentation همچنین تأکید میکند display_errors نباید روی Production فعال باشد.
WP_DEBUG_DISPLAY چیست؟
WP_DEBUG_DISPLAY تعیین میکند Debug Messageهای WordPress روی Output صفحه نمایش داده شوند یا نه.
اما فقط تنظیم این Constant همیشه کافی نیست.
PHP نیز display_errors دارد.
مستندات WordPress اشاره میکنند اگر PHP خودش برای نمایش Error پیکربندی شده باشد، ممکن است لازم باشد Configuration هر دو سطح بررسی شود.
این مثال خوبی از Defense in Depth در Error Handling است.
debug.log چرا میتواند خطرناک باشد؟
اگر Debug Log در مسیری قرار گیرد که از Web قابل دانلود باشد، ممکن است اطلاعات حساس فاش شود.
مستندات رسمی WordPress هشدار میدهند قرار دادن Error Log در مسیر عمومی میتواند Security Risk ایجاد کند و در حالت ایدهآل Log باید خارج از Public Root نگهداری شود یا دسترسی مناسب داشته باشد.
Error Handling در WooCommerce
WooCommerce و Extensionهای آن با عملیات مالی و Stateهای متعددی سروکار دارند:
Cart
Order
Payment
Refund
Inventory
Coupon
Shipping
Webhook
اگر Error Handling ناقص باشد، ممکن است:
Order در وضعیت اشتباه بماند.
Payment موفق باشد ولی Order Failed نشان داده شود.
Payment Fail شود ولی Inventory کم شود.
Webhook تکراری چند بار پردازش شود.
Refund دو بار ثبت شود.
بنابراین Error Handling باید با Business Logic و State Machine فروشگاه هماهنگ باشد.
پیام خطای Payment باید چه ویژگیای داشته باشد؟
کاربر باید بداند عملیات موفق نشده است.
اما نباید موارد زیر را ببیند:
Gateway Secret
Merchant Credential
Signature Detail
Internal Request
Database Error
Server Stack Trace
در عین حال تیم Support باید بتواند Transaction را با Reference ID پیدا کند.
این همان جداسازی User-facing Error از Internal Diagnostic است.
طراحی Error Handling از مرحله Requirement
Error Handling نباید آخر کار به Application اضافه شود.
در Requirement باید مشخص شود:
Failureهای حیاتی کداماند؟
برای هر Failure چه Stateی امن است؟
چه Errorهایی Retry میشوند؟
چه Errorهایی Rollback میشوند؟
چه Errorهایی Alert ایجاد میکنند؟
User چه Messageای میبیند؟
Support چه اطلاعاتی میبیند؟
Log چه مدت نگهداری میشود؟
اگر External Dependency قطع شود چه میشود؟
این تصمیمها بخشی از Secure Design هستند.
Threat Modeling برای Exceptional Conditions
Threat Modeling نباید فقط Happy Path را بررسی کند.
برای هر Component بپرسید:
اگر Down شود چه؟
اگر کند شود چه؟
اگر Response اشتباه بدهد چه؟
اگر Partial Response بدهد چه؟
اگر Data تکراری بدهد چه؟
اگر Exception ایجاد کند چه؟
اگر Permission Service Fail شود چه؟
اگر Clock نامعتبر باشد چه؟
اگر Disk پر شود چه؟
این سؤالات Failure Modeهای خطرناک را قبل از Production آشکار میکنند.
NIST SSDF و مدیریت ریشهای آسیبپذیریها
NIST Secure Software Development Framework یا SSDF مجموعهای از Practiceهای توسعه امن ارائه میکند که هدف آن کاهش Vulnerabilityهای نرمافزار، کاهش Impact مشکلات کشفنشده و رسیدگی به Root Cause ضعفهاست.
مدیریت Exception نیز بهتر است در همین دیدگاه قرار گیرد:
نه یک Patch بعد از Crash،
بلکه بخشی از Secure SDLC.
یعنی Error Requirement، Code Review، Test، Monitoring و Post-Incident Learning همگی باید به هم متصل باشند.
تست مدیریت خطا چگونه انجام میشود؟
Error Handling فقط با Unit Test Happy Path بررسی نمیشود.
باید Failure Injection نیز وجود داشته باشد.
مثلاً در Environment تست:
Database را قطع کنید.
External API را Timeout کنید.
Disk Quota را محدود کنید.
Parameter را حذف کنید.
Invalid Data ارسال کنید.
Response Dependency را تغییر دهید.
Request را دوبار ارسال کنید.
Resource را تحت فشار قرار دهید.
Permission را حذف کنید.
هدف این نیست که Production را خراب کنیم؛ این Testها باید در محیط کنترلشده انجام شوند.
Unit Test برای Exceptional Condition
برای Function حساس باید Test کنیم:
اگر Input Null بود چه؟
اگر Function وابسته Error داد چه؟
اگر Return Value نامعتبر بود چه؟
اگر Permission نبود چه؟
آیا Resource آزاد میشود؟
آیا Error مناسب برمیگردد؟
Integration Test
Integration Test بررسی میکند چند Component هنگام Failure چگونه رفتار میکنند.
مثلاً:
Application + Database
Backend + Payment API
API + Queue
Service + Cache
مهم است که Failure Contract بین Componentها تست شود.
Load و Stress Test
OWASP A10 اجرای Stress و Performance Test را نیز در مجموعه اقدامات پیشنهادی مطرح میکند.
زیرا بعضی Exceptional Conditionها فقط در Load بالا ظاهر میشوند.
مثلاً:
Connection Pool Exhaustion
Queue Backlog
Memory Pressure
Race Condition
Timeout Chain
Stress Test میتواند این ضعفها را قبل از حمله یا Traffic واقعی نشان دهد.
Fault Injection چیست؟
Fault Injection یعنی بهطور کنترلشده Failure در سیستم ایجاد کنیم تا ببینیم Application چگونه واکنش نشان میدهد.
مثلاً:
Latency اضافه کنیم.
Service را Down کنیم.
Network Packet Loss شبیهسازی کنیم.
Disk Failure ایجاد کنیم.
هدف کشف Behaviorهای ناامن در Failure State است.
Chaos Engineering و امنیت
Chaos Engineering بیشتر با Resilience شناخته میشود، اما میتواند اطلاعات امنیتی مفیدی هم بدهد.
اگر سرویس Authentication قطع شود و Application ناگهان همه Requestها را Allow کند، Chaos Test یک ضعف امنیتی بزرگ را آشکار کرده است.
البته آزمایشهای Chaos باید با برنامه و Safety Control اجرا شوند.
Error Handling مرکزی یا پراکنده؟
OWASP توصیه میکند مدیریت Error تا حد امکان Consistent و Centralized باشد.
اما این به معنی قرار دادن تمام Logic در یک Function نیست.
مدل مناسبتر معمولاً این است:
خطای Domain در محل مناسب مدیریت شود.
Error Format مرکزی باشد.
Logging Policy مرکزی باشد.
Global Handler وجود داشته باشد.
Error Taxonomy استاندارد باشد.
این روش Consistency ایجاد میکند بدون اینکه Context محلی از بین برود.
Error Taxonomy چیست؟
سازمان میتواند Errorها را دستهبندی کند.
مثلاً:
Validation Error
Authentication Error
Authorization Error
Business Rule Error
Dependency Error
Timeout
Resource Exhaustion
Internal Error
هر دسته میتواند رفتار استاندارد داشته باشد:
HTTP Status
Log Severity
Alert Policy
Retry Policy
User Message
این کار از Responseهای تصادفی و متناقض جلوگیری میکند.
خطای قابل بازیابی و غیرقابل بازیابی
همه Errorها Recoverable نیستند.
مثلاً Timeout موقت API شاید Retry شود.
اما Cryptographic Signature نامعتبر نباید با Retry به Success تبدیل شود.
باید مشخص شود:
کدام Error Temporary است؟
کدام Permanent؟
کدام Security-sensitive؟
کدام نیازمند Human Intervention؟
این طبقهبندی جلوی Retryهای خطرناک یا ادامه دادن در State نامعتبر را میگیرد.
خطای قابل انتظار و غیرقابل انتظار
Expected Errorها بخشی از Business Flow هستند.
مثلاً:
موجودی کافی نیست.
Coupon منقضی است.
Resource پیدا نشد.
اما Unexpected Errorها معمولاً نشاندهنده مشکل برنامه یا Infrastructure هستند.
User Message برای این دو ممکن است متفاوت باشد، اما Internal Logging و Severity نیز باید متفاوت باشد.
یکی از اشتباهات رایج: نمایش Error واقعی به User
Developer گاهی برای راحتی Debug این کار را انجام میدهد.
این رفتار ممکن است در Development قابل قبول باشد، اما Production باید متفاوت باشد.
Development Environment و Production Environment باید Error Policy جدا داشته باشند.
Production:
Generic User Message
Detailed Internal Log
Development:
Detailed Diagnostic
این Separation بسیار مهم است.
اشتباه رایج دوم: تبدیل هر Exception به Success
گاهی Developer برای جلوگیری از خراب شدن UI، Exception را Catch کرده و مقدار Default برمیگرداند.
مثلاً:
return true
یا:
return []
این کار ممکن است Error را پنهان کند.
اگر Function برای Permission Check باشد، true Default میتواند Fail Open ایجاد کند.
Default Value باید با Security Context انتخاب شود.
اشتباه رایج سوم: Retry نامحدود
Retry بدون Limit میتواند:
CPU مصرف کند.
Log تولید کند.
Dependency را بیشتر تحت فشار قرار دهد.
Queue را پر کند.
درخواستهای User را معطل کند.
Retry همیشه باید Policy داشته باشد.
اشتباه رایج چهارم: ادامه Transaction بعد از Error
اگر مرحله حیاتی Failed شده، ادامه دادن مراحل بعدی ممکن است State را خرابتر کند.
باید Explicitly مشخص باشد چه Errorهایی:
Abort
Rollback
Compensate
میشوند.
اشتباه رایج پنجم: Catch کردن Error بدون Logging
اگر Exception مهم Catch شود اما هیچ Trace داخلی نداشته باشد، تیم فنی شاید هرگز متوجه مشکل نشود.
البته Logging نیز باید با Severity مناسب و بدون Sensitive Data انجام شود.
اشتباه رایج ششم: Logging همه Data
برعکس مورد قبل، Logging بیش از حد هم خطرناک است.
Full Request Body ممکن است:
Password
Token
PII
Payment Data
داشته باشد.
Logging Policy باید Fieldهای حساس را Redact کند.
اشتباه رایج هفتم: یک پیام متفاوت برای هر Failure حساس
Response بسیار دقیق ممکن است Internal State را فاش کند.
در Authentication و Password Reset باید Information Disclosure بررسی شود.
اشتباه رایج هشتم: اعتماد به Frontend برای جلوگیری از Error
اگر Form در Browser یک Field را Required تعریف کرده، مهاجم همچنان میتواند Request خام ارسال کند.
Backend باید Missing/Extra/Invalid Parameter را مدیریت کند.
اشتباه رایج نهم: Debug فعال در Production
Development Setting باید از Production جدا باشد.
در WordPress نیز WP_DEBUG و Error Display روی Live Site توصیه نمیشوند.
اشتباه رایج دهم: Error Handling بدون Monitoring
ممکن است Application Error را «خوب» مدیریت کند و User چیزی نبیند، اما همان Error روزانه هزاران بار رخ دهد.
اگر Monitoring وجود نداشته باشد، Failure پنهان میماند. 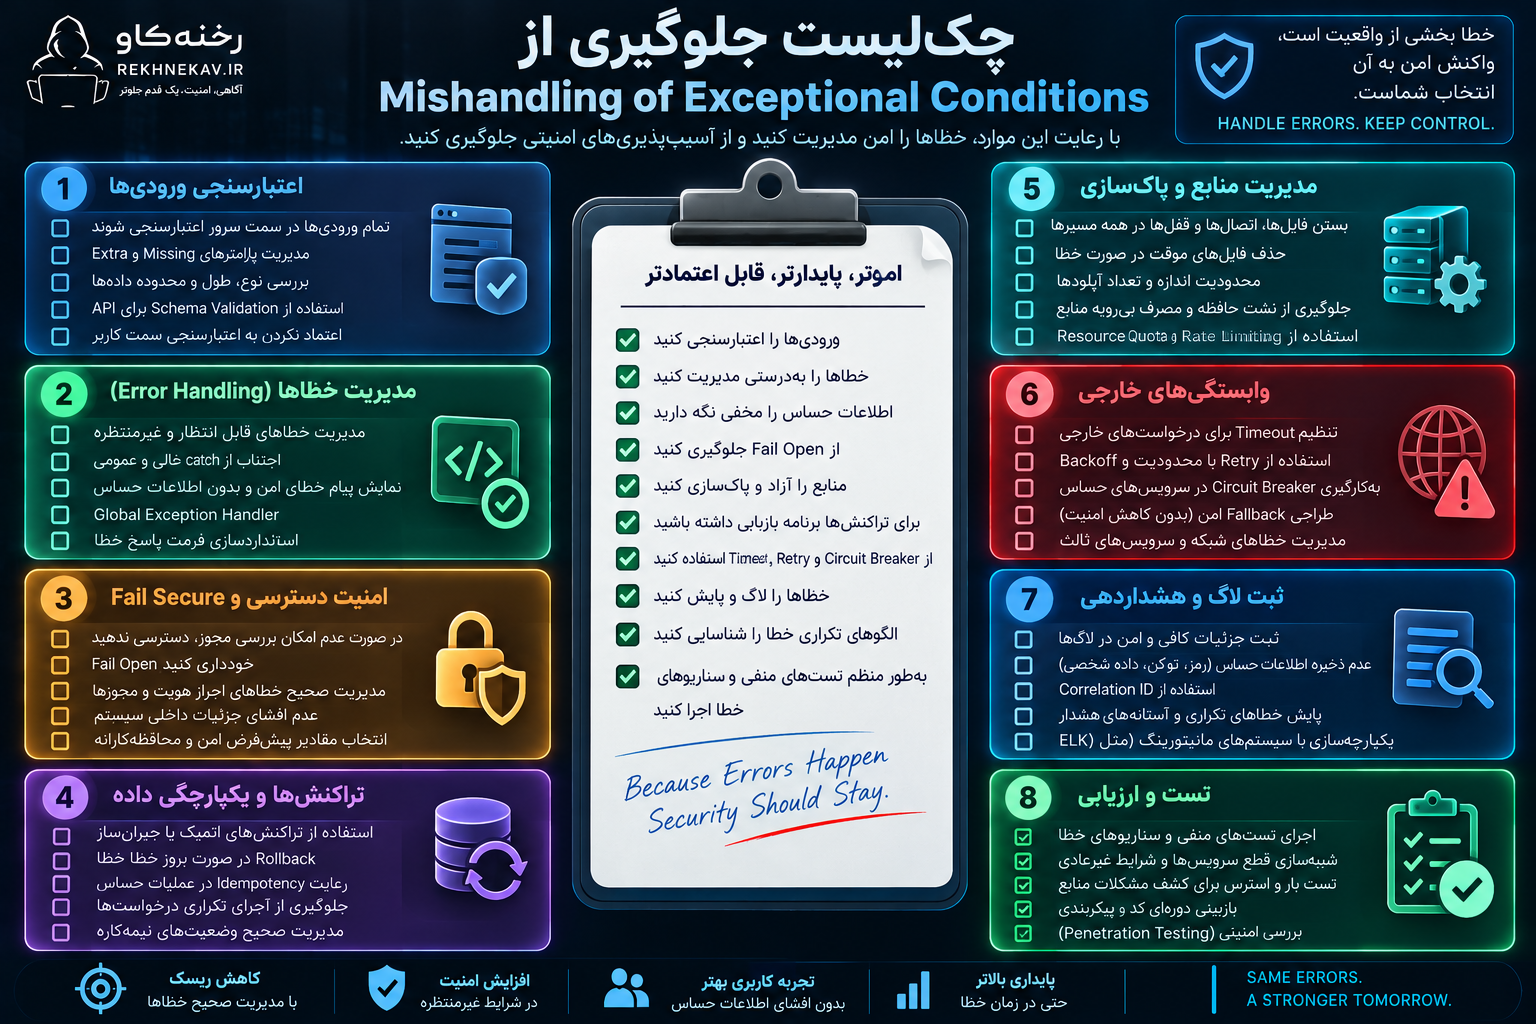
چکلیست جلوگیری از Mishandling of Exceptional Conditions
ورودی و Validation
- تمام Inputهای سمت Server اعتبارسنجی شوند.
- Required Parameterها صریح تعریف شوند.
- Extra Parameterهای غیرمجاز Reject یا Ignore امن شوند.
- Type، Range و Length بررسی شود.
- Client-side Validation کنترل امنیتی اصلی نباشد.
- Schema Validation برای API در نظر گرفته شود.
Error Handling
- Errorهای قابل انتظار بهصورت مشخص Handle شوند.
- Catch Block خالی وجود نداشته باشد.
- Exceptionهای Generic بدون ضرورت Catch نشوند.
- Global Exception Handler وجود داشته باشد.
- User-facing Message از Internal Detail جدا باشد.
- Response Error استاندارد باشد.
Fail Secure
- Failure کنترل دسترسی باعث Allow نشود.
- Verification Failure به حالت Permissive تبدیل نشود.
- Transaction نامطمئن Complete تلقی نشود.
- Defaultهای امنیتی Conservative باشند.
- Failure State از قبل Design شده باشد.
Transaction
- عملیات چندمرحلهای Atomic یا دارای Compensation مناسب باشند.
- Rollback برای Failureهای حساس تعریف شود.
- Duplicate Request مدیریت شود.
- Idempotency برای عملیات مالی بررسی شود.
- State Transitionها معتبر باشند.
Resource Management
- File Handleها بسته شوند.
- Connectionها آزاد شوند.
- Lockها Release شوند.
- Temporary Fileها Cleanup شوند.
- Resource Quota تعریف شود.
- Timeout مناسب وجود داشته باشد.
Dependency
- External API دارای Timeout باشد.
- Retry Limit وجود داشته باشد.
- Exponential Backoff در صورت نیاز استفاده شود.
- Fallback امنیت را کاهش ندهد.
- Circuit Breaker در Architectureهای مناسب بررسی شود.
Logging
- Exceptionهای مهم Log شوند.
- Password و Secret Log نشوند.
- Tokenها Redact شوند.
- Correlation ID استفاده شود.
- Logها از دسترسی غیرمجاز محافظت شوند.
- Error Rate Monitor شود.
Alerting
- افزایش Errorهای امنیتی Alert ایجاد کند.
- Errorهای مکرر دستهبندی شوند.
- Alert Fatigue مدیریت شود.
- Threshold مشخص وجود داشته باشد.
- Incident Response به Alert متصل باشد.
Production
- Stack Trace به User نمایش داده نشود.
- Debug Mode غیرفعال باشد.
- Error Page سفارشی وجود داشته باشد.
- Server Versionهای غیرضروری فاش نشوند.
- Log File عمومی نباشد.
Testing
- Unit Test برای Error Path وجود داشته باشد.
- Negative Testing انجام شود.
- Integration Failure تست شود.
- Timeout تست شود.
- Resource Exhaustion بررسی شود.
- Stress Test انجام شود.
- Penetration Test Error Handling را بررسی کند.
چکلیست مخصوص سایت WordPress
برای سایت WordPress موارد زیر اهمیت ویژه دارند:
- WP_DEBUG روی Production غیرفعال باشد.
- WP_DEBUG_DISPLAY روی Production فعال نباشد.
- PHP
display_errorsبررسی شود. - debug.log از Web عمومی قابل دانلود نباشد.
- Pluginهای اختصاصی Error Handling مشخص داشته باشند.
- REST APIها Stack Trace برنگردانند.
- Ajax Handlerها Error Response استاندارد داشته باشند.
- External API Callها Timeout داشته باشند.
- WooCommerce Payment Failure State بررسی شود.
- Webhookها Idempotent باشند.
- Cron Job Failureها Log و Monitor شوند.
- File Upload Error باعث Resource Leak نشود.
- Database Error مستقیم به User نشان داده نشود.
- اطلاعات حساس در Log ثبت نشوند.
چگونه یک سایت موجود را از نظر A10 بررسی کنیم؟
مرحله اول Critical Flowها را مشخص کنید.
مثلاً:
Login
Register
Password Reset
Payment
Checkout
Wallet
Upload
Profile Change
API
Admin Operation
مرحله دوم برای هر Flow Failure Pointها را مشخص کنید.
مثلاً برای Payment:
Gateway Timeout
Invalid Signature
Duplicate Callback
Database Error
Network Failure
User Cancel
مرحله سوم بررسی کنید:
سیستم چه Responseای میدهد؟
State چه میشود؟
چه چیزی Log میشود؟
آیا Retry انجام میشود؟
آیا Rollback انجام میشود؟
آیا User اطلاعات حساس میبیند؟
این روش بسیار مؤثرتر از جستجوی تصادفی try/catch در Source Code است.
Code Review باید دنبال چه چیزهایی بگردد؟
در Code Review میتوان موارد زیر را بررسی کرد:
Empty Catch
Generic Catch
Unchecked Return Value
Fail-open Default
Missing Cleanup
Sensitive Error Output
Debug Code
Missing Timeout
Infinite Retry
Partial Transaction
Inconsistent Error Handling
Missing Parameter Handling
Null Handling
Authorization Error Handling
Resource Leak
هدف صرفاً Code Style نیست.
باید دید Error چه تأثیری بر Security State دارد.
آیا WAF جلوی این ریسک را میگیرد؟
نه بهطور کامل.
WAF میتواند برخی Inputهای مخرب یا Patternهای Attack را Block کند.
اما نمیتواند:
Transaction ناقص را Rollback کند.
File Handle را آزاد کند.
Authorization Fallback را اصلاح کند.
Retry Loop را متوقف کند.
Business State را Restore کند.
Stack Trace داخلی Code را بهدرستی مدیریت کند.
WAF یک Layer دفاعی است، نه جایگزین Error Handling امن.
آیا Exception زیاد به معنی سایت ناامن است؟
نه.
Exception بهخودیخود Vulnerability نیست.
حتی Software خوب نیز Exception دارد.
موضوع اصلی این است:
Exception چگونه ایجاد میشود؟
چگونه مدیریت میشود؟
پس از آن State سیستم چیست؟
چه اطلاعاتی نمایش داده میشود؟
آیا Resource آزاد شده؟
آیا Security Control همچنان برقرار است؟
امنیت در کیفیت Response به Exception است، نه صرفاً تعداد Exceptionها.
آیا مخفی کردن تمام Errorها راهکار درستی است؟
خیر.
مخفی کردن Error از User و مخفی کردن Error از Developer دو موضوع متفاوت هستند.
User نباید Technical Detail غیرضروری ببیند.
اما تیم Operations باید Visibility کافی داشته باشد.
اگر Errorها کاملاً Silent شوند، Incident Detection ضعیف خواهد شد.
مدل صحیح:
Safe Error for User
Detailed Secure Log for Team
Alert for Important Pattern
است.
Error Handling و E-E-A-T سایت
Mishandling of Exceptional Conditions مستقیماً یک فاکتور سئو یا E-E-A-T نیست.
اما Reliability و Security سرویس روی تجربه و اعتماد کاربران اثر واقعی دارند.
سایتی که هنگام خطا:
اطلاعات Database نمایش دهد،
Orderها را اشتباه ثبت کند،
Payment را دوبار انجام دهد،
یا مرتب Crash کند،
اعتماد کاربران را کاهش میدهد.
خصوصاً در سایتهای:
مالی
فروشگاهی
پزشکی
عضویت محور
که State و اطلاعات حساس اهمیت زیادی دارند.
سؤالات متداول درباره Mishandling of Exceptional Conditions
Mishandling of Exceptional Conditions چیست؟
Mishandling of Exceptional Conditions به شرایطی گفته میشود که Application هنگام Error یا وضعیت غیرمعمول نتواند بهدرستی آن را پیشگیری، شناسایی یا مدیریت کند و در نتیجه وارد State ناامن یا غیرقابل پیشبینی شود.
این آسیبپذیری در OWASP Top 10 چه رتبهای دارد؟
در OWASP Top 10 2025 این دسته با شناسه A10 در رتبه دهم قرار دارد و یک Category جدید در نسخه ۲۰۲۵ است.
چند CWE در A10:2025 وجود دارد؟
OWASP برای این دسته ۲۴ CWE معرفی کرده است.
Fail Open چیست؟
Fail Open یعنی سیستم هنگام Failure به وضعیتی برود که Security Control ضعیفتر شود؛ برای مثال اگر Authorization قابل بررسی نبود، دسترسی صادر شود. CWE-636 به این ضعف اختصاص دارد.
Fail Closed چیست؟
Fail Closed یعنی در صورت Failure حساس، سیستم عملیات را متوقف کند و تا زمانی که شرایط امنیتی مشخص نشده دسترسی یا عملیات حساس صادر نشود.
آیا Stack Trace باید به کاربر نشان داده شود؟
روی Production معمولاً خیر. جزئیات Stack Trace میتوانند اطلاعات فنی درباره Architecture، Framework، File Path یا Logic برنامه افشا کنند. OWASP توصیه میکند User Message عمومیتر باشد و جزئیات لازم به شکل امن در Log داخلی ذخیره شوند.
Global Exception Handler چیست؟
یک Handler مرکزی است که Exceptionهایی را که در سطوح پایینتر مدیریت نشدهاند دریافت میکند و Response، Logging و در صورت نیاز Alert استاندارد ایجاد میکند.
آیا Global Handler جایگزین مدیریت محلی Error است؟
خیر. Global Handler Safety Net است. Errorهای مربوط به Transaction، Resource یا Business State باید تا حد امکان در Contextی مدیریت شوند که امکان Recovery مناسب وجود دارد.
چرا Catch خالی خطرناک است؟
زیرا Error را مخفی میکند بدون اینکه State اصلاح شود. ممکن است برنامه پس از Failure به کار خود ادامه دهد در حالی که اطلاعات یا Resourceها در وضعیت نامعتبر هستند.
چرا Error Message میتواند آسیبپذیری ایجاد کند؟
اگر Error حاوی اطلاعات حساس مانند SQL Query، File Path، Stack Trace، Secret یا Internal Configuration باشد، مهاجم میتواند از آن برای Reconnaissance یا حمله دقیقتر استفاده کند.
آیا WP_DEBUG روی سایت اصلی باید فعال باشد؟
مستندات رسمی WordPress استفاده از WP_DEBUG و Debug Toolهای مشابه روی Live Site را توصیه نمیکنند و آنها را بیشتر برای Development و Staging در نظر میگیرند.
آیا PHP display_errors روی Production باید فعال باشد؟
مستندات امنیتی WordPress توصیه میکنند display_errors روی Production غیرفعال باشد، زیرا نمایش Error میتواند اطلاعات فنی غیرضروری در اختیار کاربران قرار دهد.
Retry چه زمانی خطرناک است؟
وقتی نامحدود باشد، بدون Backoff اجرا شود یا عملیات Idempotent نباشد. چنین Retryهایی میتوانند Resource Consumption، Duplicate Transaction یا فشار بیشتر به Dependency ایجاد کنند.
Idempotency چیست؟
یعنی تکرار همان Request باعث ایجاد اثر ناخواسته تکراری نشود. این ویژگی در عملیات مالی، Payment، Refund و Webhook اهمیت زیادی دارد.
آیا Rate Limiting با Error Handling ارتباط دارد؟
بله. Rate Limiting، Throttling و Resource Quota میتوانند از ایجاد برخی Exceptional Conditionها مانند Resource Exhaustion جلوگیری کنند. OWASP آنها را در راهکارهای A10 پیشنهاد میکند.
آیا Logging تمام Exceptionها کافی است؟
خیر. Error باید علاوه بر Logging بهدرستی Handle شود. در شرایط لازم Monitoring و Alerting نیز باید وجود داشته باشند.
آیا Error Handling ضعیف میتواند باعث DoS شود؟
بله. برای مثال Exceptionهایی که باعث Resource Leak شوند میتوانند پس از تکرار، Connection، Memory یا Storage موجود را تمام کنند. OWASP نمونهای از این سناریو را در A10 ارائه کرده است.
مدیریت Error در عملیات مالی چگونه باید باشد؟
عملیات باید State مشخص، Rollback یا Compensation مناسب، Idempotency و Logging داشته باشند تا Failure در وسط Transaction به Debit/Credit یا ثبت چندباره منجر نشود.
آیا Error Handling بخشی از Secure by Design است؟
بله. Failure State و Exceptional Condition باید از مرحله Requirement و Design در نظر گرفته شوند، نه اینکه پس از Production بهصورت Patch اضافه شوند.
جمعبندی
Mishandling of Exceptional Conditions یکی از مهمترین یادآوریهای OWASP Top 10 2025 است: یک نرمافزار فقط در شرایط عادی باید امن نباشد؛ هنگام خراب شدن نیز باید امن باقی بماند.
بسیاری از آسیبپذیریها زمانی ظاهر میشوند که Application وارد مسیری میشود که Developer تصور نکرده است.
Database پاسخ نمیدهد.
Network قطع میشود.
Parameter وجود ندارد.
Permission Service Fail میشود.
Transaction نیمهکاره میماند.
Resource تمام میشود.
File Upload ناقص میشود.
API خارجی Response غیرمنتظره میدهد.
اگر در چنین لحظاتی Application نداند چه کاری باید انجام دهد، ممکن است به وضعیت ناامن وارد شود.
یکی از خطرناکترین نمونهها Fail Open است؛ یعنی یک Security Control هنگام Error بهجای محدودتر شدن، permissive شود.
اصل امن این است که اگر Permission قابل تأیید نیست، دسترسی صادر نشود.
اگر Signature معتبر نیست، Data Trusted محسوب نشود.
اگر Payment State مشخص نیست، Order بدون بررسی Paid اعلام نشود.
اگر Transaction در نیمه راه شکست خورد، System State بهصورت کامل Rollback یا Compensate شود.
در کنار Fail Secure، مدیریت Error باید Information Disclosure را نیز کنترل کند.
Stack Trace، SQL Query، Internal Path و Secretها نباید به کاربران Production نمایش داده شوند.
User باید یک پیام قابل فهم و امن دریافت کند، در حالی که تیم فنی از طریق Log محافظتشده، Correlation ID، Monitoring و Alerting اطلاعات لازم برای Investigation را داشته باشد.
از طرف دیگر، Error Handling نباید فقط Reactive باشد.
Input Validation، Rate Limiting، Resource Quota، Timeout، Idempotency، Transaction Design و Threat Modeling میتوانند بسیاری از Exceptional Conditionها را قبل از تبدیل شدن به Incident کنترل کنند.
OWASP همچنین توصیه میکند Error Handling بهصورت Consistent و تا حد ممکن متمرکز انجام شود، Global Exception Handler وجود داشته باشد و Error Patternهای تکراری با Monitoring و Observability شناسایی شوند.
برای سایتهای WordPress و WooCommerce نیز این اصول کاملاً کاربردی هستند.
WP_DEBUG و Error Display روی Production نباید بدون ضرورت فعال باشند، Logها نباید از Web عمومی قابل دسترس باشند و Pluginهای سفارشی، REST APIها، Payment Gatewayها، Webhookها و عملیات مالی باید Failure State مشخص داشته باشند.
در نهایت، مدیریت امن Exception را میتوان در یک اصل خلاصه کرد:
یک سیستم امن فقط نمیداند در زمان موفقیت چه کاری انجام دهد؛ از قبل میداند وقتی همه چیز طبق انتظار پیش نرفت، چگونه بدون افشای اطلاعات، تخریب State یا حذف کنترلهای امنیتی به یک وضعیت امن برگردد.
مطالب مرتبط